使用 TensorRT 加速
TensorRT 是 NVIDIA 的高性能推理引擎,通过算子融合、精度量化(FP16/INT8)、内核自动调优等手段,显著提升模型在 GPU 上的推理速度。在 Jetson 上,TensorRT 随 JetPack 预装,无需单独安装,是模型部署的标准路径。
典型流程为:训练框架(PyTorch 等)→ 导出 ONNX → TensorRT 构建引擎(.engine)→ C++ 或 Python 加载引擎推理。
TIP
以下教程以 JetPack 6.2.x(TensorRT 10.x) 为例。TensorRT 10 移除了旧版 enqueueV2 / execute_async_v2 等接口,本文示例均为新版 API。
1. 确认环境
# 查看 TensorRT 版本
dpkg -l | grep tensorrt

# trtexec 位置(命令行转换/测速工具)
ls /usr/src/tensorrt/bin/trtexec
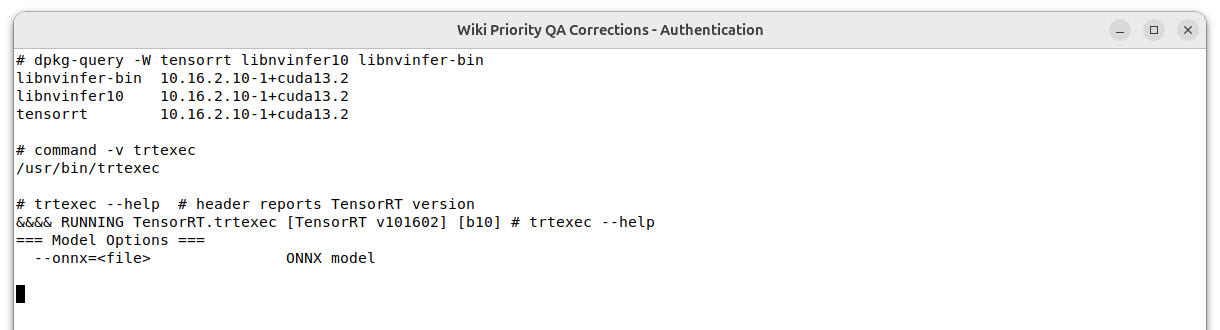
实机环境确认示例(JetPack 7.2.1 / TensorRT 10.16):
2. 用 trtexec 快速转换与测速
trtexec 是官方自带的命令行工具,适合快速验证模型能否转换、以及测延迟,不需要写代码。
2.1 导出 ONNX
以 PyTorch / Ultralytics 为例(安装见 PyTorch 教程):
yolo export model=yolo11s.pt format=onnx imgsz=6402.2 构建引擎并测速
# 构建 FP16 引擎
/usr/src/tensorrt/bin/trtexec --onnx=yolo11s.onnx --saveEngine=yolo11s_fp16.engine --fp16

# 只测速(直接加载引擎,跑 200 次迭代)
/usr/src/tensorrt/bin/trtexec --loadEngine=yolo11s_fp16.engine --iterations=200 --avgRuns=100
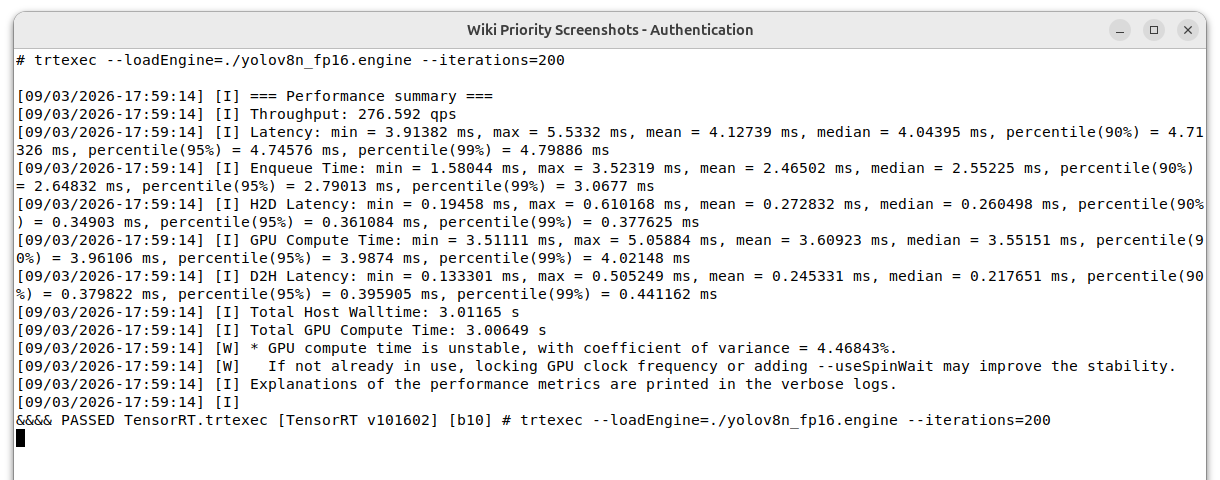
下面是 Orin Nano Super 在 25W 模式下使用既有 YOLOv8n FP16 engine 运行 200 次迭代的实测摘要。不同模型、输入尺寸、功耗模式和 TensorRT 版本的结果不能直接横向比较。
常用参数:
| 参数 | 说明 |
|---|---|
--fp16 | 启用 FP16 精度(Jetson 上收益最大、几乎无精度损失) |
--int8 | 启用 INT8(需校准数据,精度有损失) |
--minShapes / --optShapes / --maxShapes | 动态输入尺寸时使用 |
--verbose | 打印详细构建信息,排查转换失败时很有用 |
Ultralytics 也可以一行导出 TensorRT 引擎:
yolo export model=yolo11s.pt format=engine half=True device=0,导出后可直接在 YOLO 推理例程 中把YOLO("yolo11s.pt")换成YOLO("yolo11s.engine")。
3. Python 绑定
3.1 安装
# TensorRT Python 绑定(JetPack 源)
sudo apt install python3-libnvinfer python3-libnvinfer-dev

# 显存拷贝需要 pycuda
pip install pycuda
验证:
python3 -c "import tensorrt; print(tensorrt.__version__)"3.2 加载引擎并推理
完整示例(输入/输出名与形状以实际模型为准,可用 trtexec --loadEngine=... --verbose 或下方代码中的打印查询):
import numpy as np
import tensorrt as trt
import pycuda.driver as cuda
import pycuda.autoinit  # 初始化 CUDA context

ENGINE_PATH = "yolo11s_fp16.engine"

# 1. 反序列化引擎
logger = trt.Logger(trt.Logger.WARNING)
with open(ENGINE_PATH, "rb") as f, trt.Runtime(logger) as runtime:
    engine = runtime.deserialize_cuda_engine(f.read())
context = engine.create_execution_context()

# 2. 查看输入/输出张量名称
for i in range(engine.num_io_tensors):
    name = engine.get_tensor_name(i)
    print(name, engine.get_tensor_mode(name), engine.get_tensor_shape(name))

# 3. 准备输入/输出缓冲区(以 1x3x640x640 输入为例)
inp_name = engine.get_tensor_name(0)          # 例如 "images"
out_name = engine.get_tensor_name(1)          # 例如 "output0"
inp = np.random.rand(1, 3, 640, 640).astype(np.float32)
context.set_input_shape(inp_name, inp.shape)  # 动态形状模型必须先设置
out_shape = tuple(context.get_tensor_shape(out_name))
out = np.empty(out_shape, dtype=np.float32)

d_in = cuda.mem_alloc(inp.nbytes)
d_out = cuda.mem_alloc(out.nbytes)
stream = cuda.Stream()

context.set_tensor_address(inp_name, int(d_in))
context.set_tensor_address(out_name, int(d_out))

# 4. 执行推理
cuda.memcpy_htod_async(d_in, inp, stream)     # 主机 -> 设备
context.execute_async_v3(stream.handle)       # 异步执行
cuda.memcpy_dtoh_async(out, d_out, stream)    # 设备 -> 主机
stream.synchronize()

print(out.shape, out.flatten()[:5])
4. C++
4.1 推理示例 infer.cpp
#include <NvInfer.h>
#include <cuda_runtime.h>
#include <fstream>
#include <iostream>
#include <vector>

class Logger : public nvinfer1::ILogger {
    void log(Severity s, const char* msg) noexcept override {
        if (s <= Severity::kWARNING) std::cout << msg << std::endl;
    }
} gLogger;

int main(int argc, char** argv) {
    if (argc < 2) { std::cerr << "usage: " << argv[0] << " model.engine\n"; return 1; }

    // 1. 读取并反序列化引擎
    std::ifstream file(argv[1], std::ios::binary | std::ios::ate);
    std::streamsize size = file.tellg();
    file.seekg(0);
    std::vector<char> blob(size);
    file.read(blob.data(), size);

    nvinfer1::IRuntime* runtime = nvinfer1::createInferRuntime(gLogger);
    nvinfer1::ICudaEngine* engine = runtime->deserializeCudaEngine(blob.data(), size);
    nvinfer1::IExecutionContext* ctx = engine->createExecutionContext();

    // 2. 获取输入/输出张量名称
    const char* inpName = engine->getIOTensorName(0);
    const char* outName = engine->getIOTensorName(1);

    // 3. 设置输入形状并分配显存(以 1x3x640x640 为例)
    ctx->setInputShape(inpName, nvinfer1::Dims4{1, 3, 640, 640});
    auto outDims = ctx->getTensorShape(outName);

    size_t inpBytes = 1 * 3 * 640 * 640 * sizeof(float);
    size_t outCount = 1;
    for (int i = 0; i < outDims.nbDims; i++) outCount *= outDims.d[i];
    size_t outBytes = outCount * sizeof(float);

    void *dIn, *dOut;
    cudaMalloc(&dIn, inpBytes);
    cudaMalloc(&dOut, outBytes);
    ctx->setTensorAddress(inpName, dIn);
    ctx->setTensorAddress(outName, dOut);

    // 4. 拷贝输入、执行、取回输出
    std::vector<float> inp(inpBytes / sizeof(float), 0.5f);
    std::vector<float> out(outCount);
    cudaStream_t stream;
    cudaStreamCreate(&stream);

    cudaMemcpyAsync(dIn, inp.data(), inpBytes, cudaMemcpyHostToDevice, stream);
    ctx->enqueueV3(stream);
    cudaMemcpyAsync(out.data(), dOut, outBytes, cudaMemcpyDeviceToHost, stream);
    cudaStreamSynchronize(stream);

    std::cout << "output[0..4]: ";
    for (int i = 0; i < 5; i++) std::cout << out[i] << " ";
    std::cout << std::endl;

    cudaStreamDestroy(stream);
    cudaFree(dIn); cudaFree(dOut);
    delete ctx; delete engine; delete runtime;
    return 0;
}
4.2 编译
CMakeLists.txt:
cmake_minimum_required(VERSION 3.16)
project(trt_infer CXX)
find_package(CUDA REQUIRED)
add_executable(infer infer.cpp)
target_include_directories(infer PRIVATE ${CUDA_INCLUDE_DIRS} /usr/include/aarch64-linux-gnu)
target_link_libraries(infer nvinfer cudart)mkdir build && cd build
cmake .. && make
./infer ../yolo11s_fp16.engine5. 常见问题
enqueueV2/execute_async报错不存在:TensorRT 10 已移除旧接口,用set_tensor_address + execute_async_v3(Python)或setTensorAddress + enqueueV3(C++)。- 引擎不能跨设备/跨版本使用:
.engine与 GPU 架构、TensorRT 版本绑定,换板卡或升级 JetPack 后需重新构建。 - 构建失败看算子:先用
trtexec --onnx=... --verbose确认哪个算子不支持,再考虑简化模型或写插件。 - 首次推理慢:引擎首次执行包含显存分配与预热,测速请丢弃前若干帧(
trtexec默认有 warmup)。